Problema
Una universidad se entera de que un estudiante desertó cuando ya se fue. En ese momento ninguna intervención es posible. El problema no era predecir por predecir: era invertir el orden, para que el área de Bienestar pudiera actuar mientras todavía había alguien a quien acompañar.
El dato que define todo el proyecto
Un modelo que dice “nadie deserta”, sin mirar ningún dato, acierta el 60,85% de las veces — porque esa es la proporción de quienes se gradúan. Y detecta cero estudiantes en riesgo.
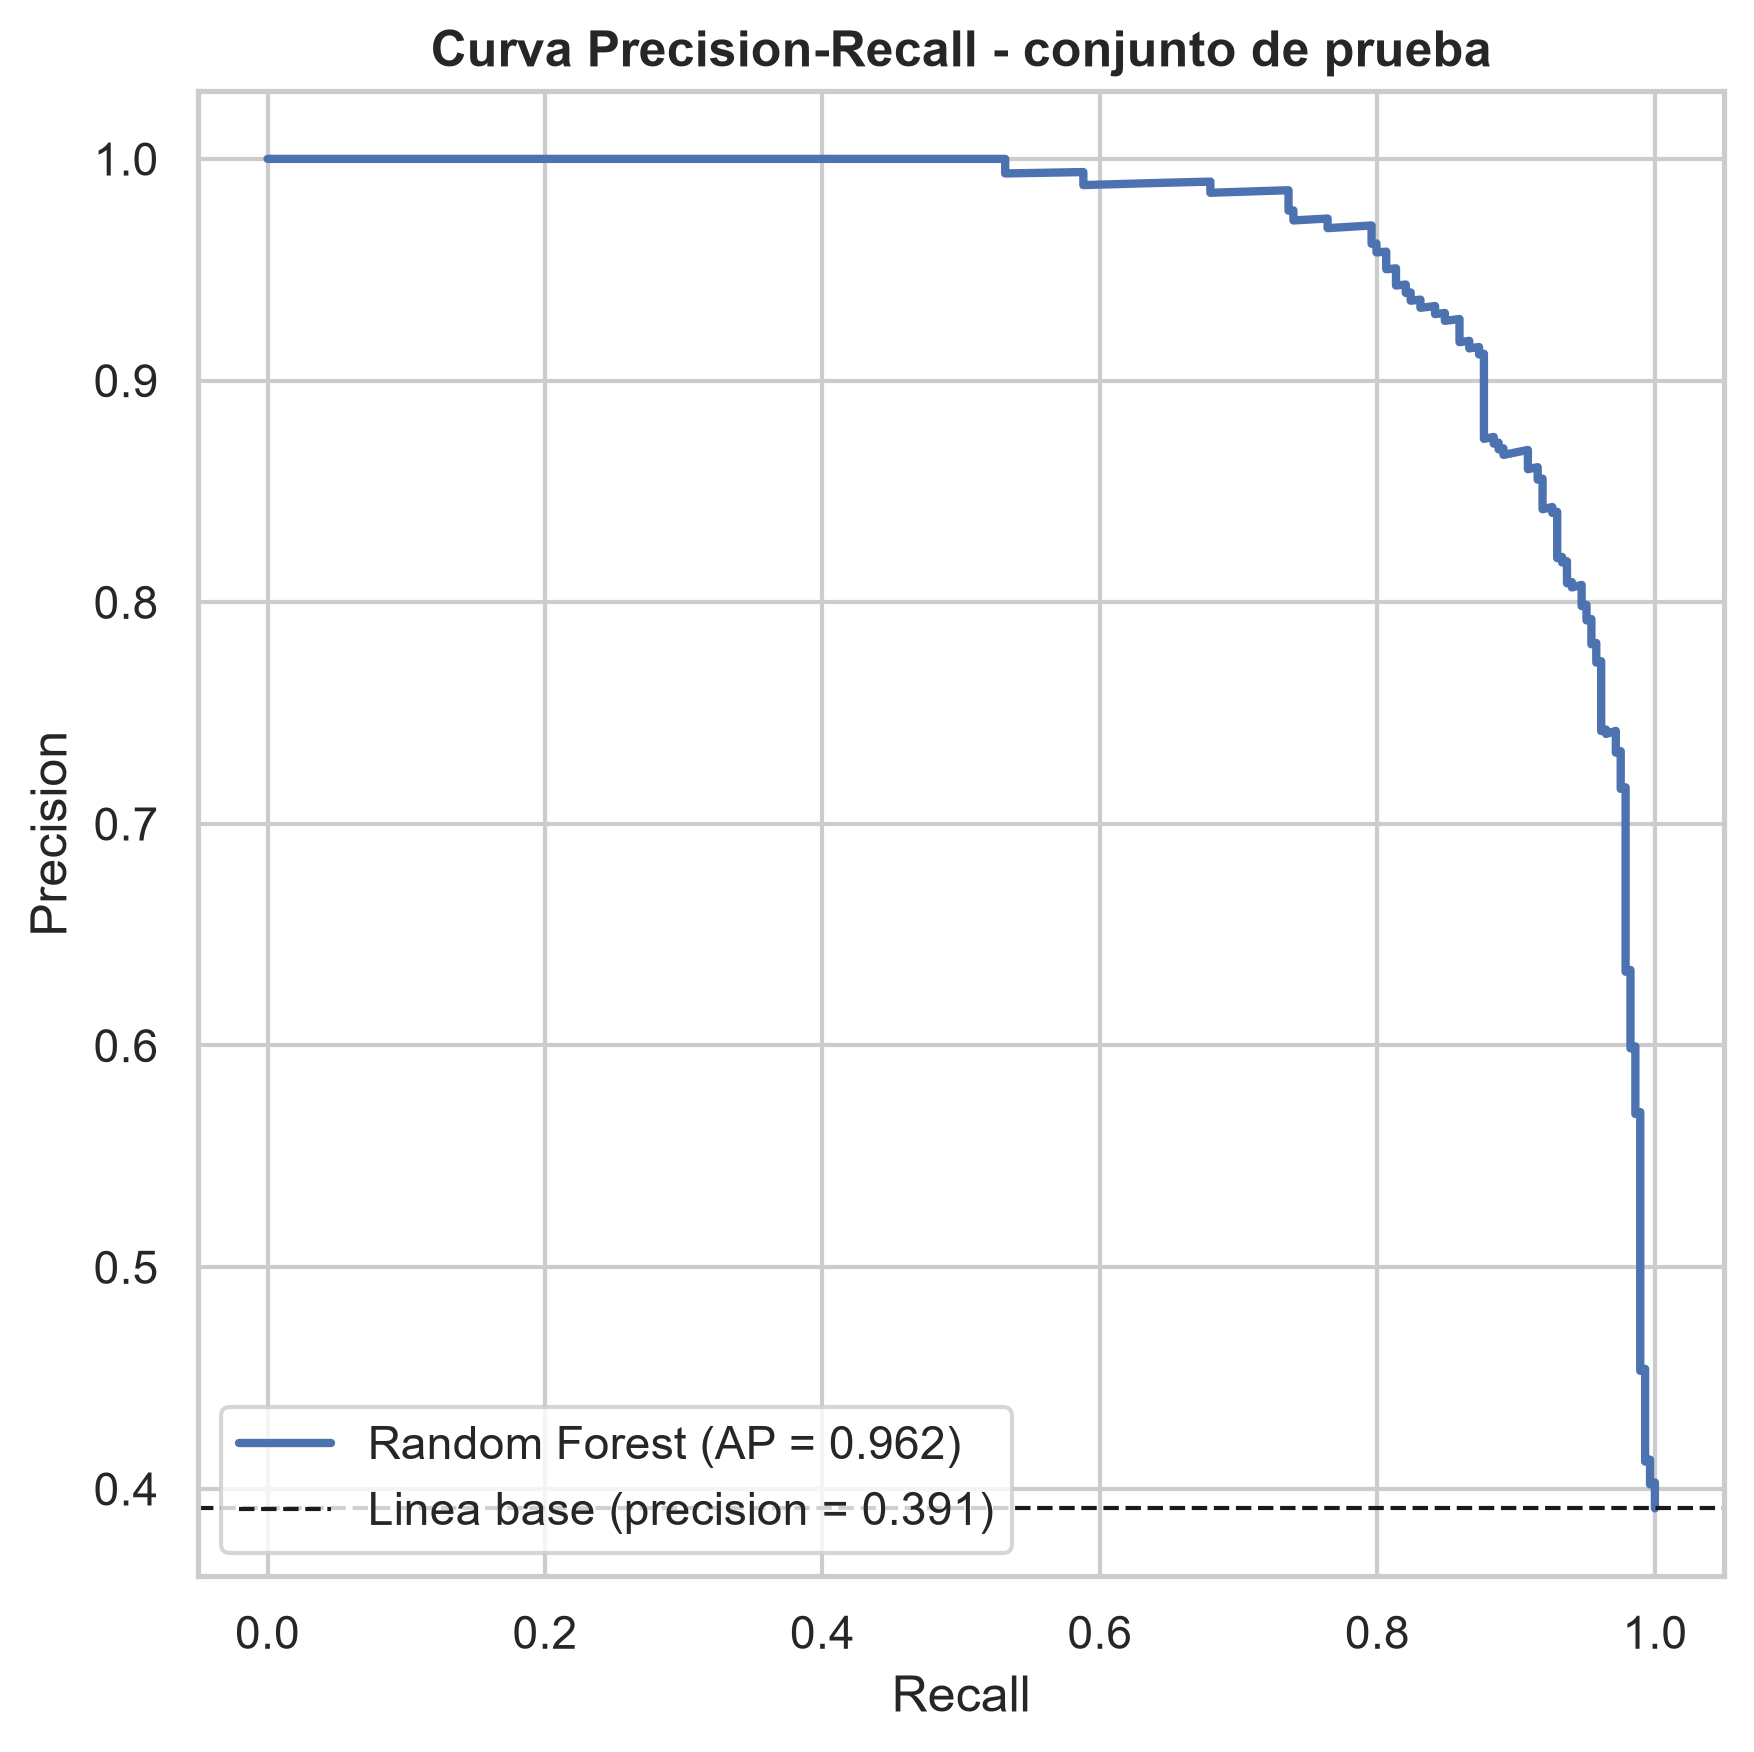
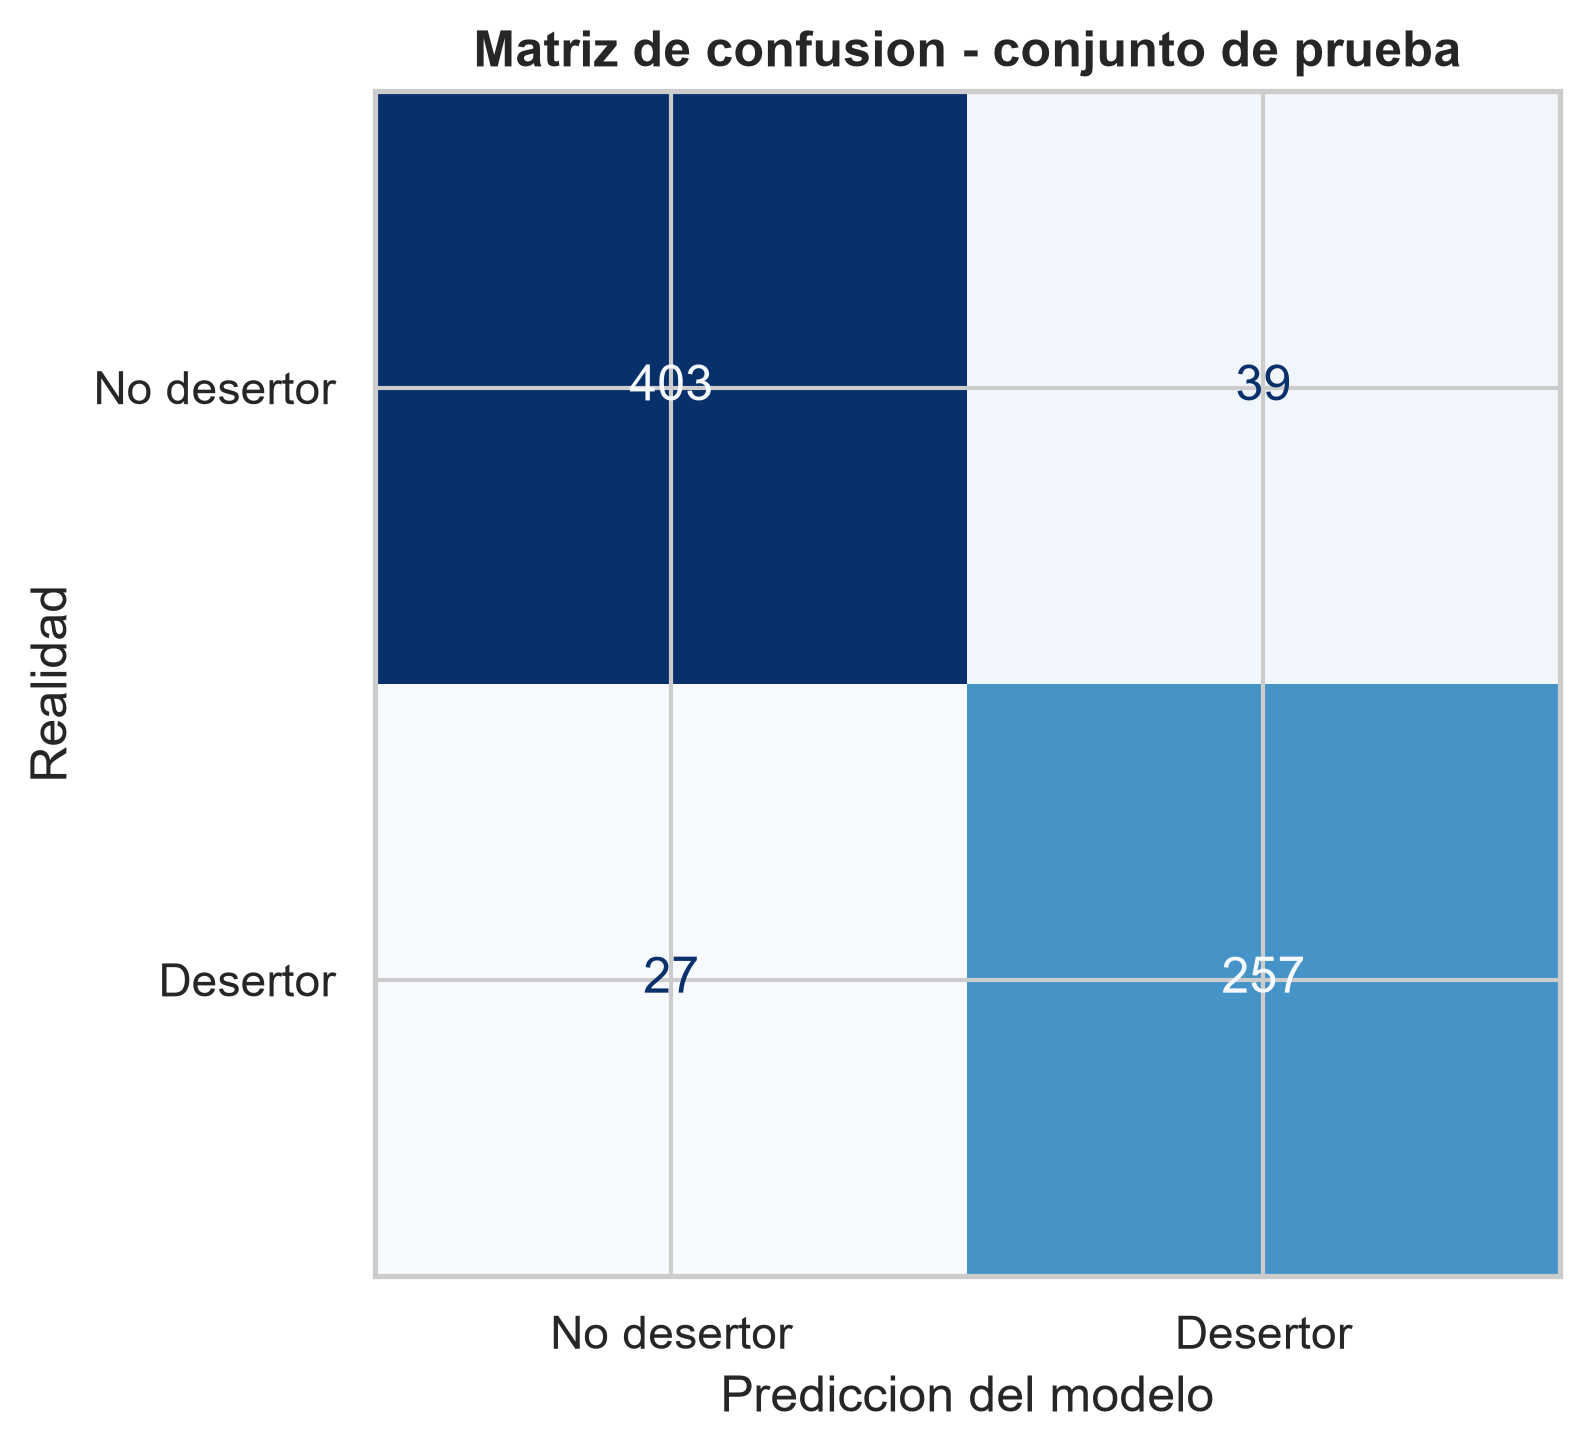
Por eso la métrica de éxito no fue la exactitud sino el Recall: de los que realmente están en riesgo, ¿a cuántos alcanzo a detectar? Elegir la métrica según lo que cuesta el error, y no la que se ve mejor en un reporte, fue la decisión más importante del trabajo.
Análisis
Sobre 4.424 registros y 37 variables: exploración de datos, detección de valores atípicos, correlaciones y tratamiento del desbalanceo de clases.
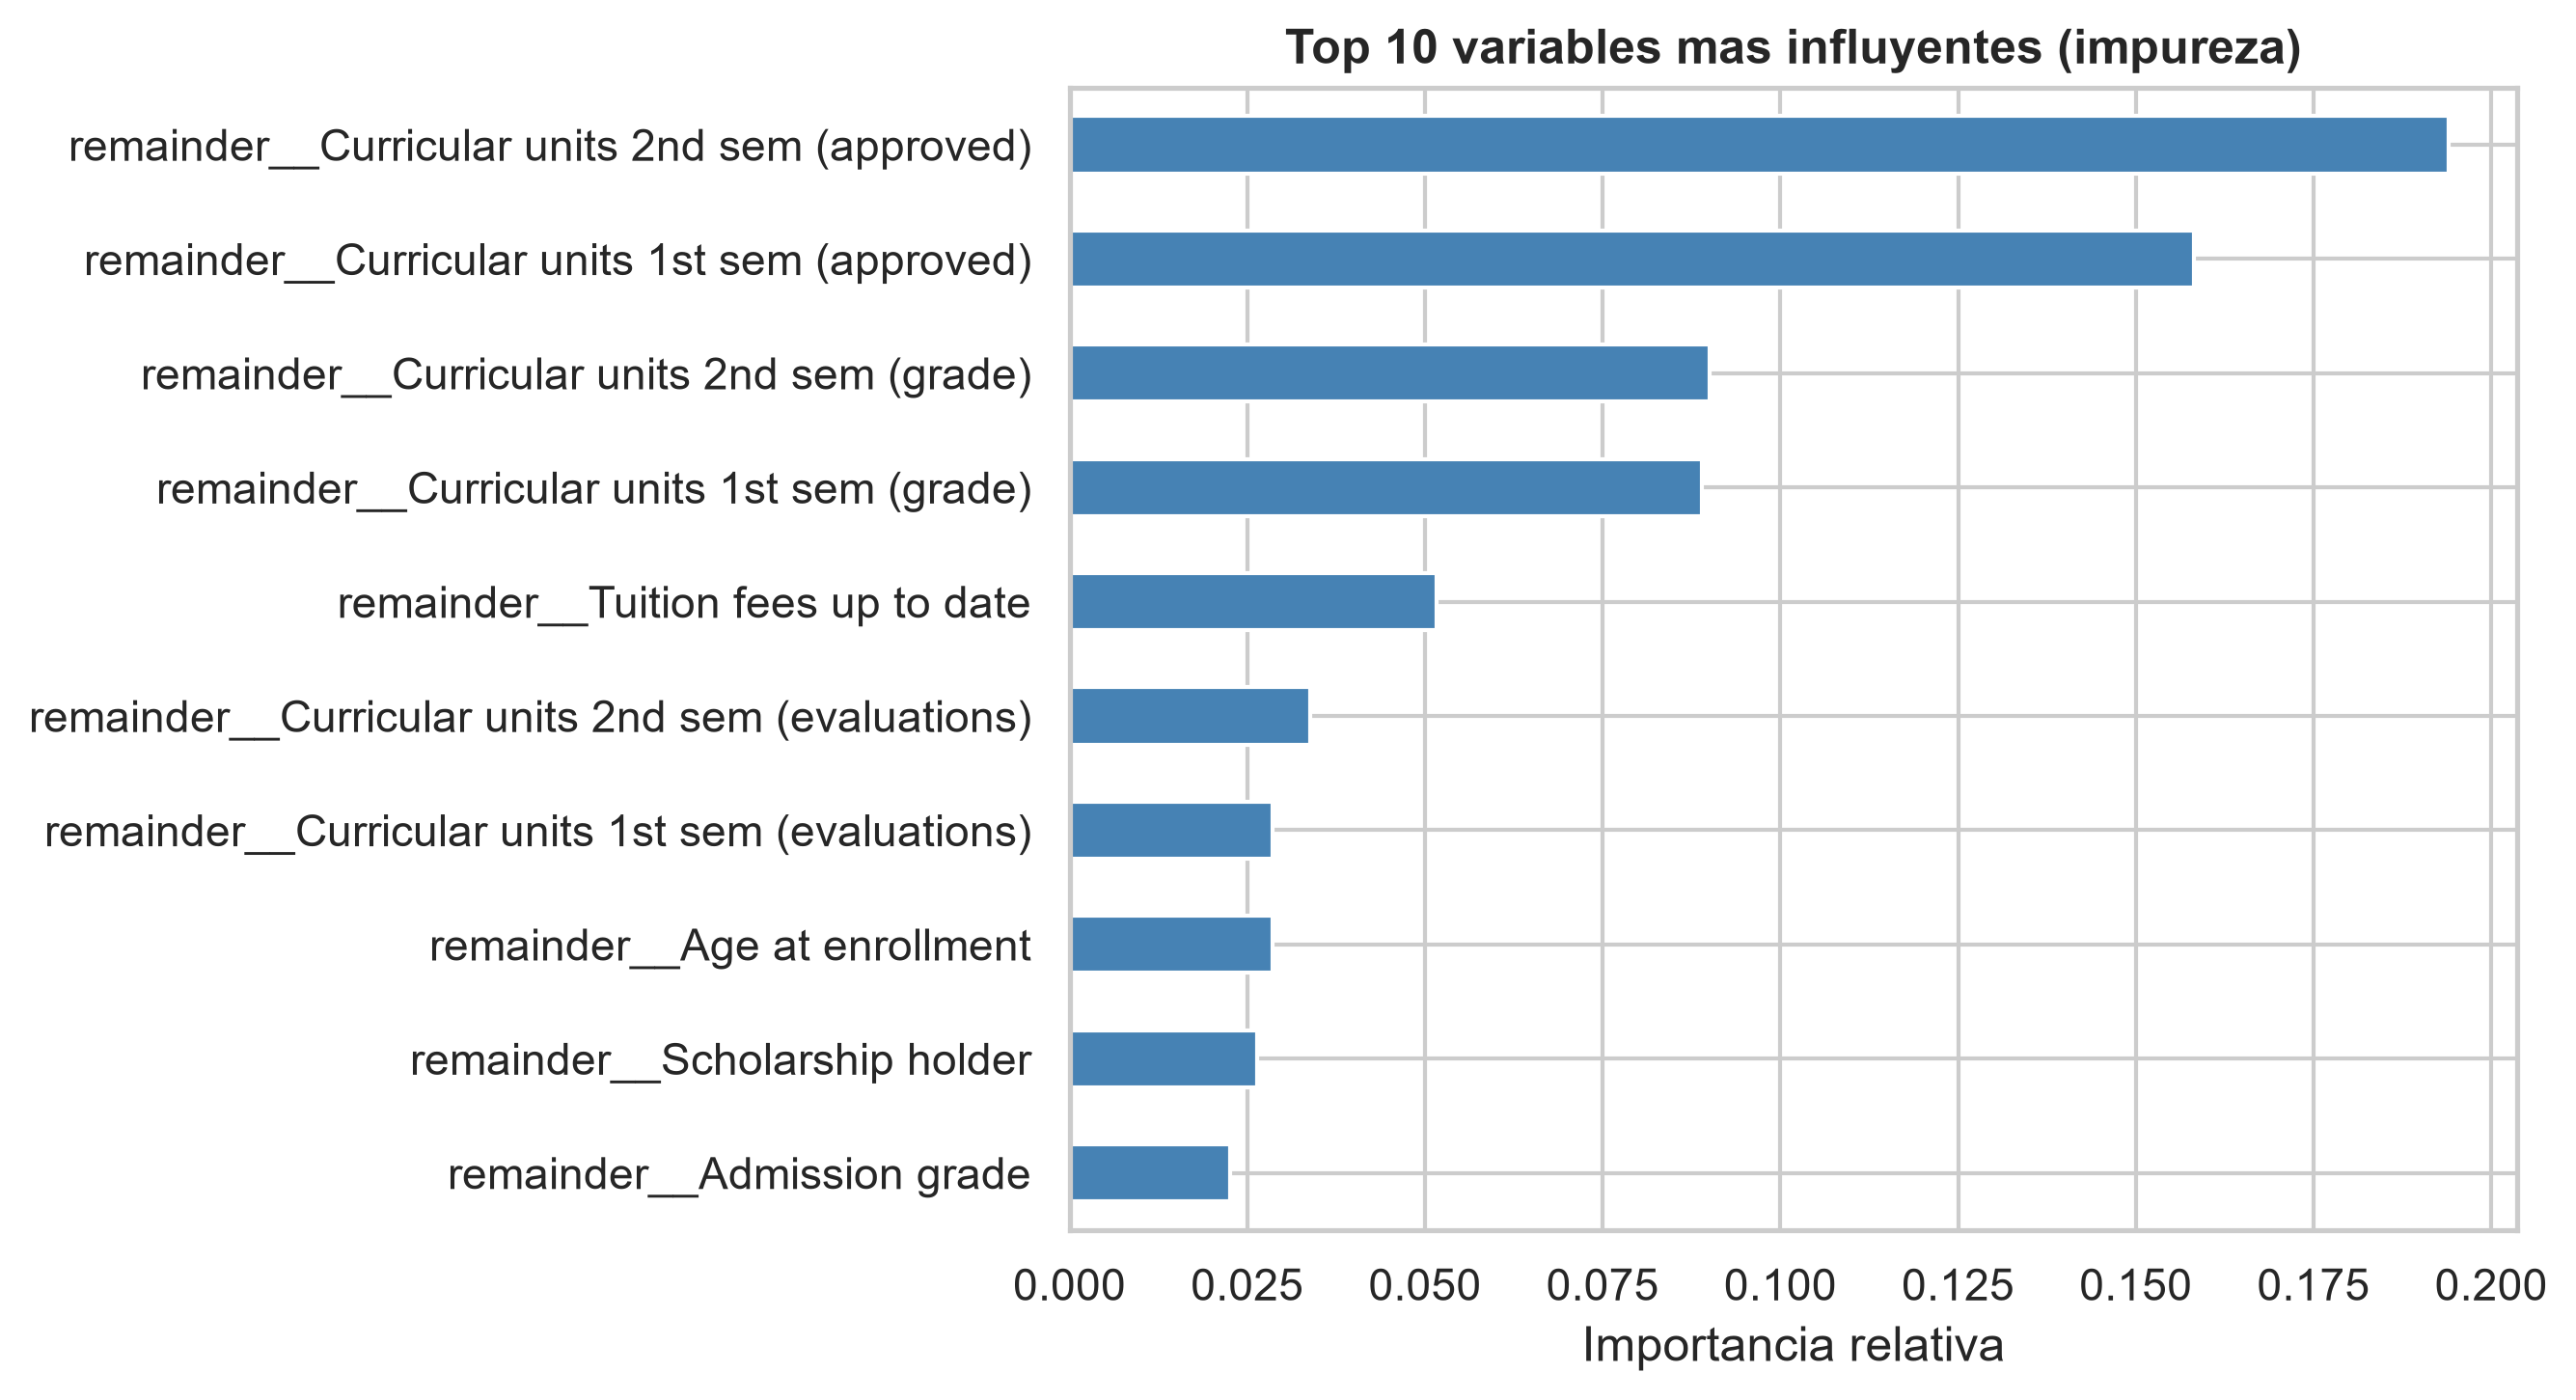
Un hallazgo del análisis exploratorio cambió el preprocesamiento: 718 notas en cero durante el primer semestre no eran datos faltantes — coincidían exactamente con quienes no aprobaron ninguna materia. Imputarlas habría borrado la señal más fuerte del conjunto.
Se compararon seis alternativas con validación cruzada estratificada y pruebas estadísticas pareadas, documentando cuándo las diferencias eran significativas y cuándo no se distinguían del ruido.
Resultado
El entregable es una API, no un tablero
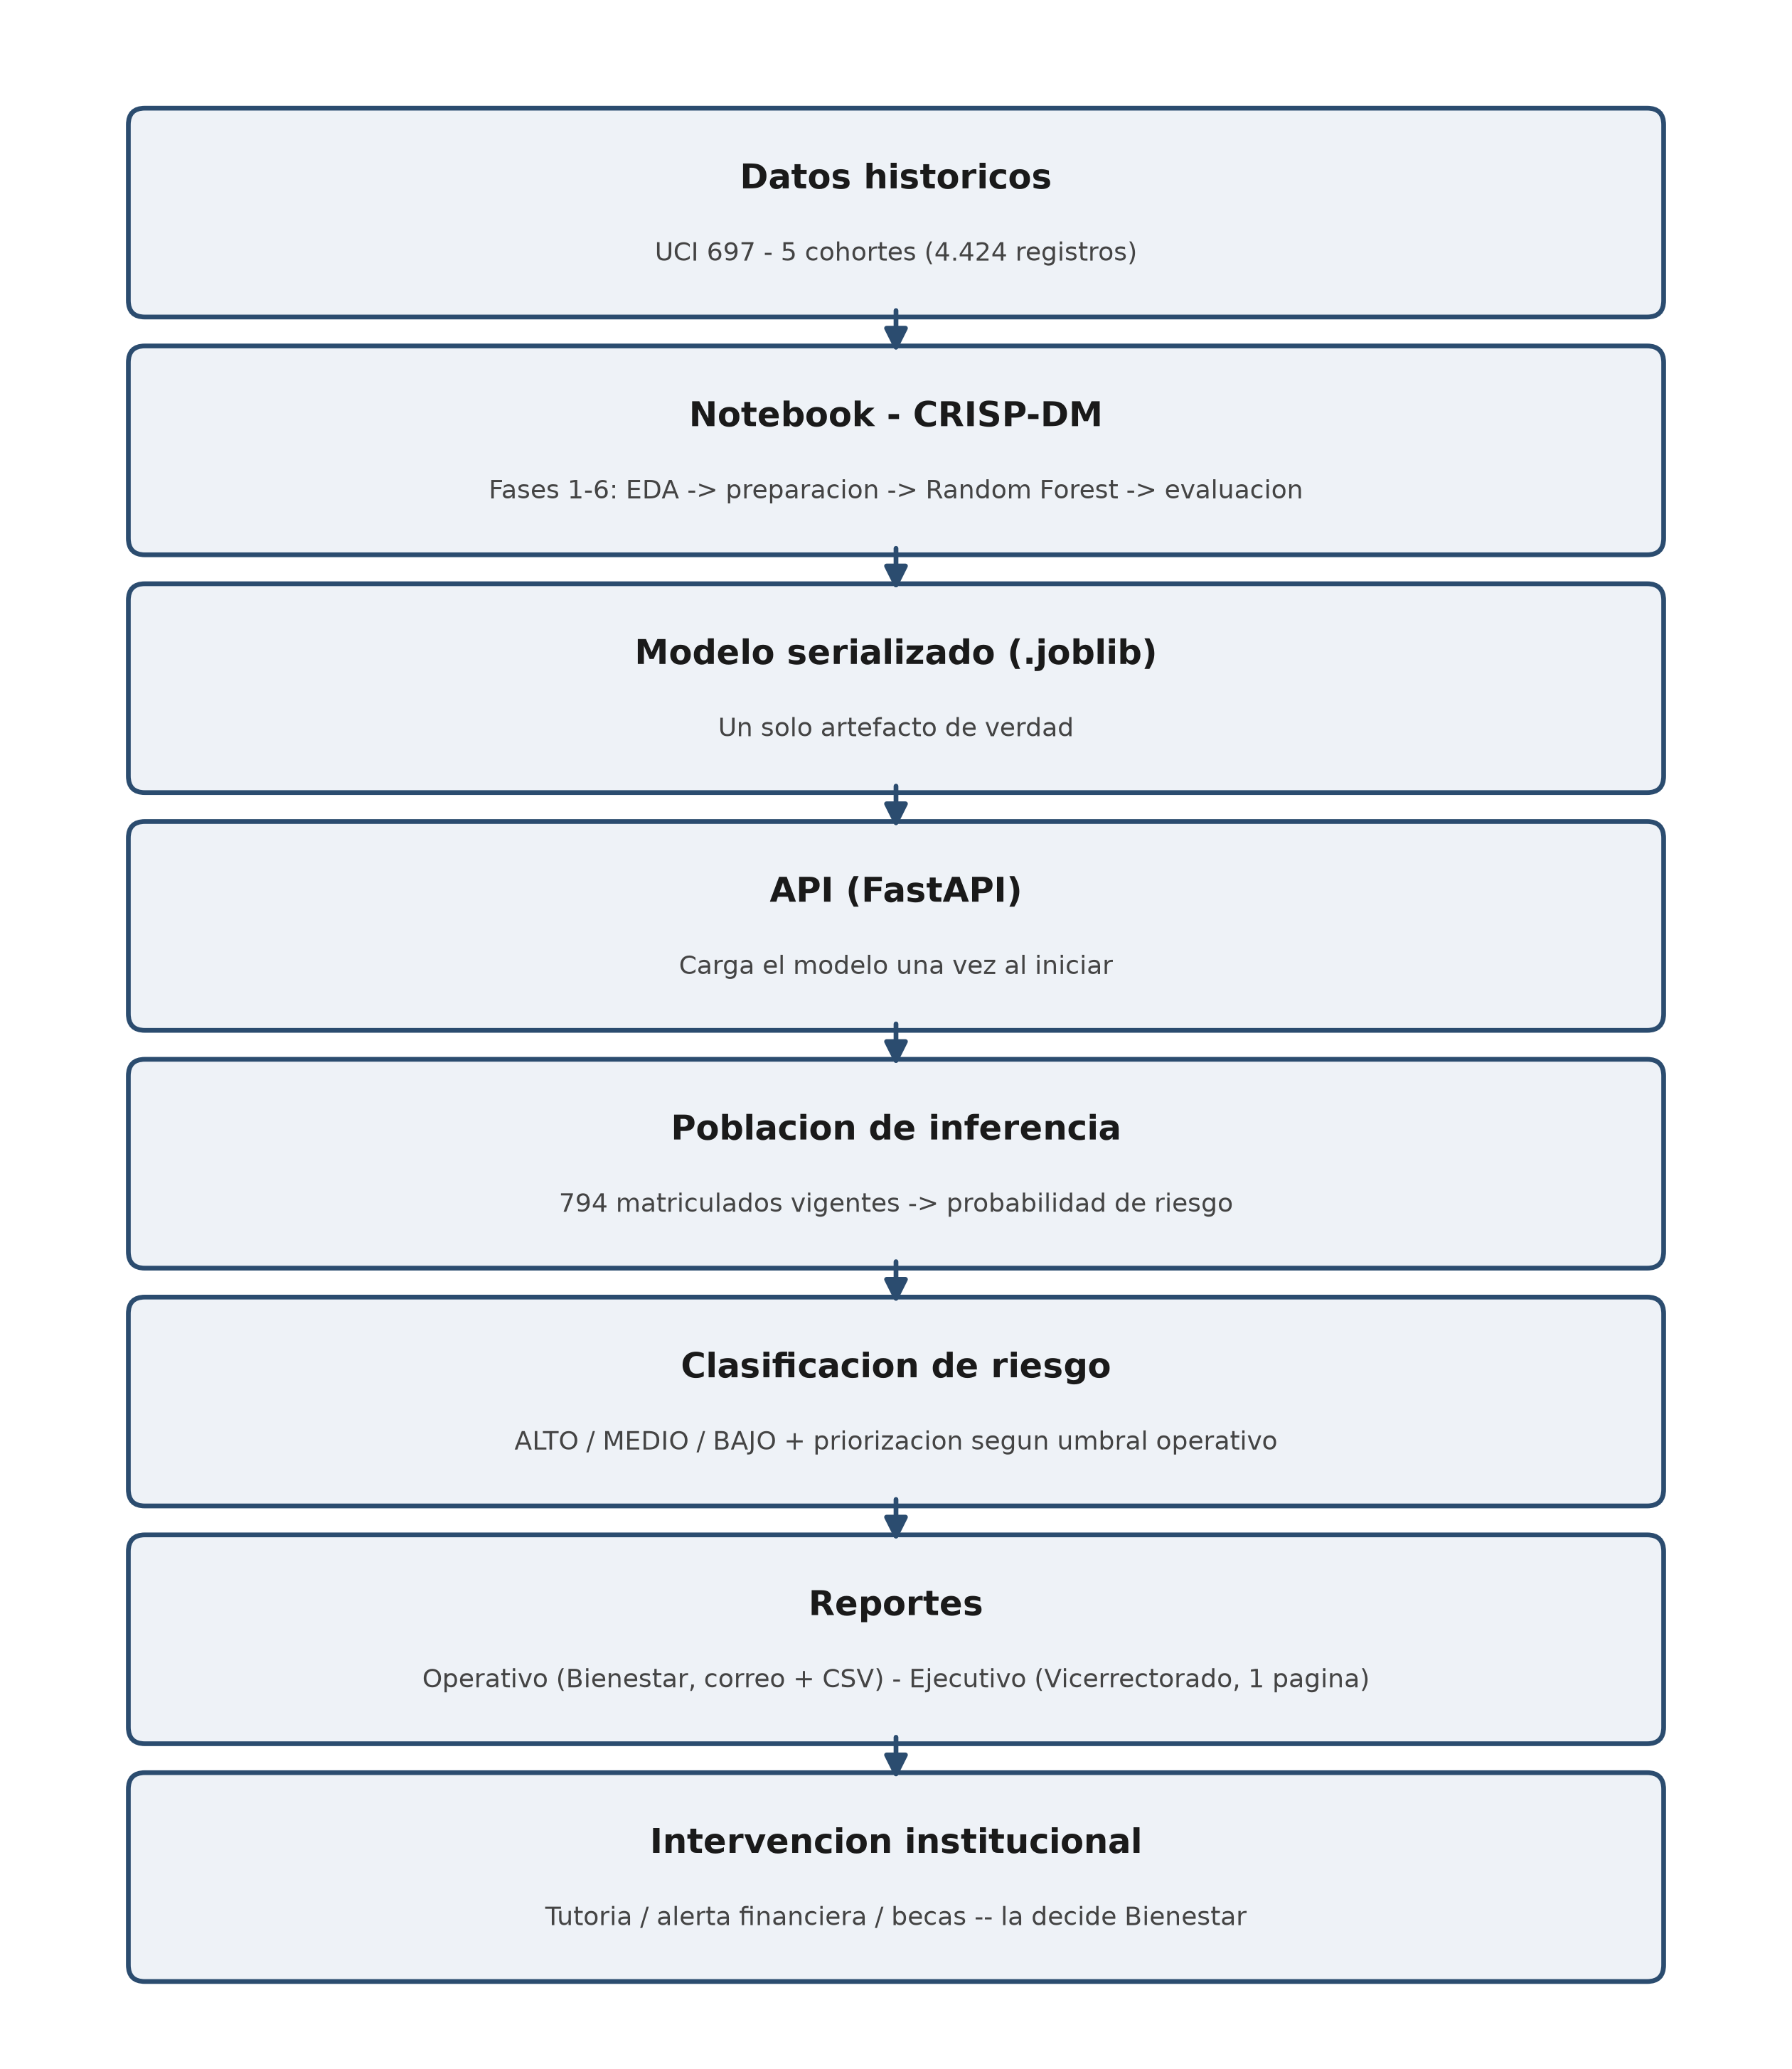
Un modelo dentro de un notebook no lo usa nadie. Por eso lo que se entrega es una API REST desplegada, con endpoints de predicción, reporte y estado del servicio, y el contrato validado: si llega un valor fuera de rango, responde con el error correspondiente en vez de devolver una predicción sin sentido.
Eso permite que la universidad la conecte a sus propios sistemas — al que ya usa para matrículas, notas o seguimiento — sin depender de que alguien abra un notebook y corra celdas.
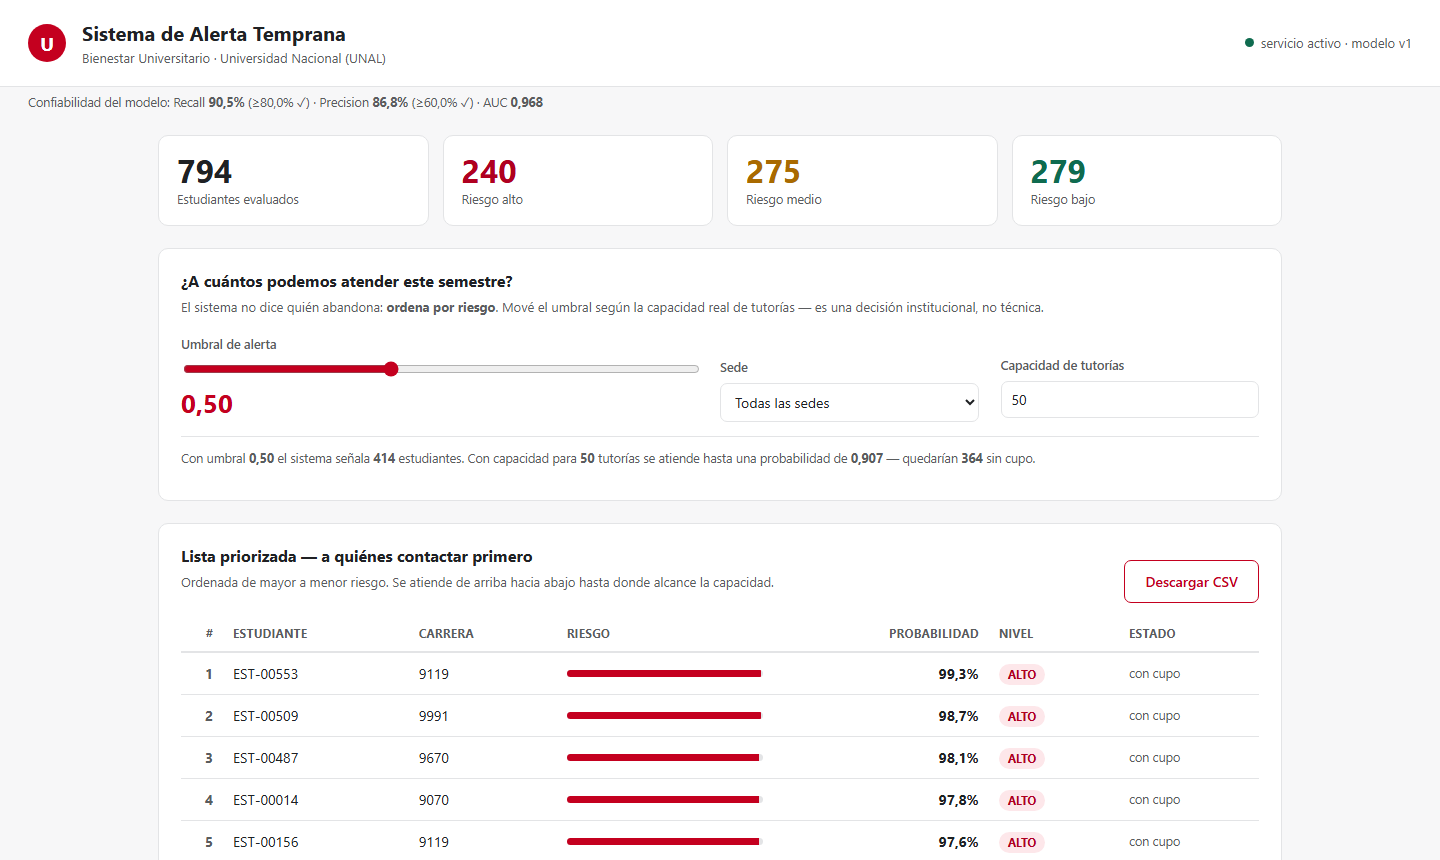
Encima de esa API construí una interfaz, y su función es distinta: demostrar las capacidades del servicio a quien no programa. Ahí se mueve el umbral y se ve en vivo a cuántas personas alcanza cada escenario según la capacidad real de tutorías del período. La interfaz existe para que se entienda qué hace la API; el producto integrable es la API.
Una decisión de comunicación, no de modelo
El reporte nunca dice “desertor”. Informa nivel de riesgo, el motivo concreto de ese estudiante y una acción sugerida.
Un archivo que circula por una institución etiquetando a alguien por algo que todavía no ocurrió puede provocar exactamente lo que intenta evitar. El sistema ordena y prioriza; la decisión sobre una persona sigue siendo humana.